
AI 模组
HGX H2 00 8 Card GPU Module
大显存 HBM3e AI 推理训练旗舰模组
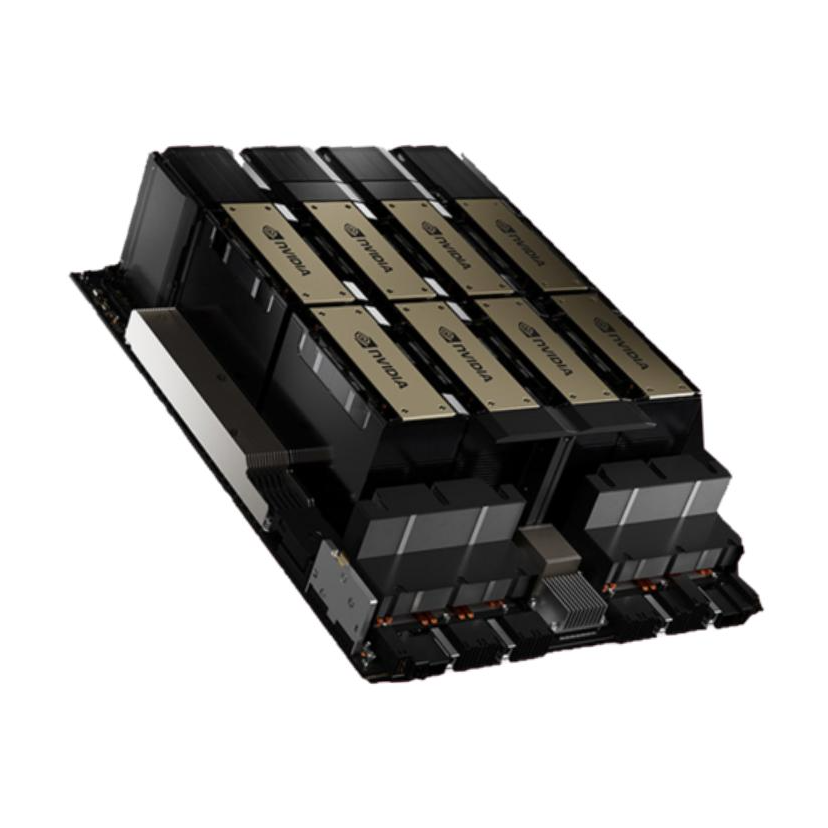
HGX H200 8卡 GPU模组
大显存 HBM3e AI 推理训练旗舰模组
搭载 HBM3e 超大显存的 Hopper 架构 AI 超算模组平台
- 面向超大模型训练推理的 1.1TB 大显存
- HBM3e 4.8TB/s 显存带宽,较 H100 提升 1.4 倍
- 第四代 NVLink 900GB/s 超强互联带宽
- FP8 Tensor Engine 与企业级可靠性
GPU
8 GPUs
NVIDIA H200 141GB SXM5
VRAM
1.1TB
HBM3e 4.8TB/s
NVLink
900GB/s
第四代全互联
FP8
3,958 TFLOPS
合计约 32 PFLOPS
Aggregated Bandwidth
38TB/s
8 卡合计
Product Overview
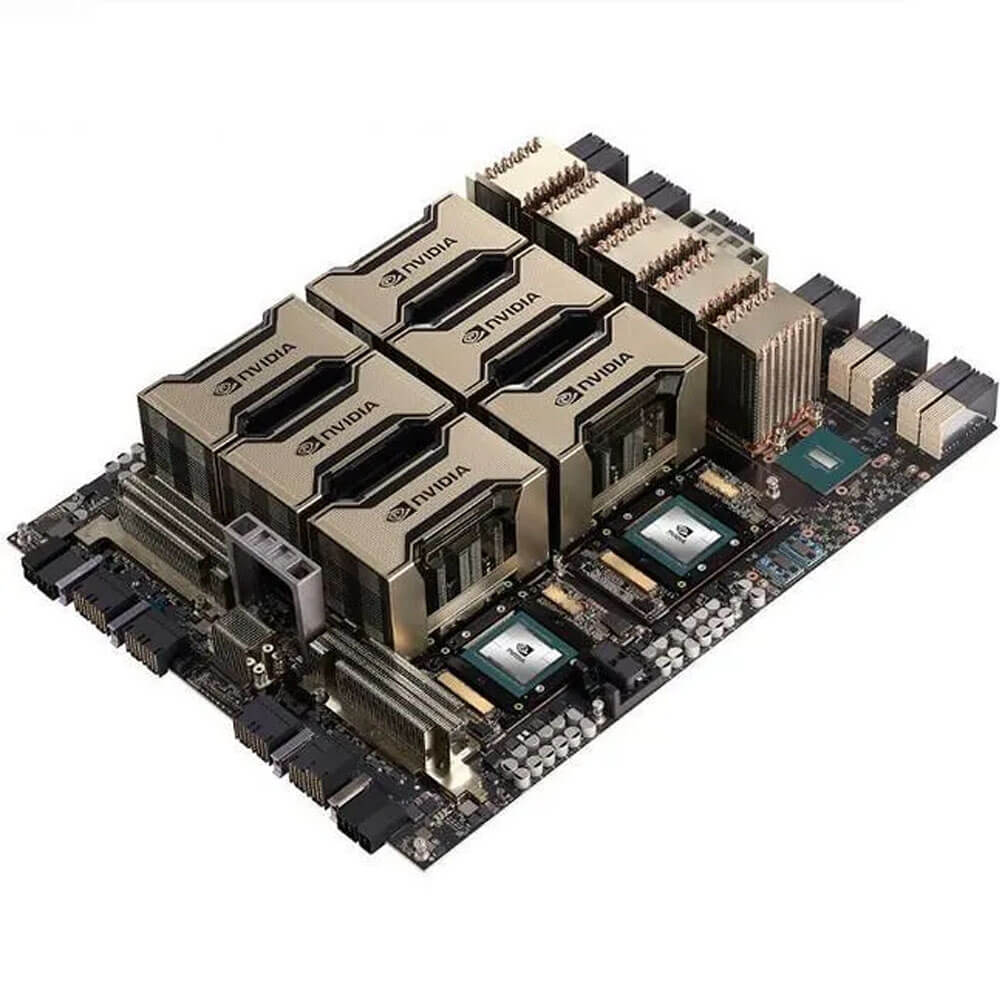
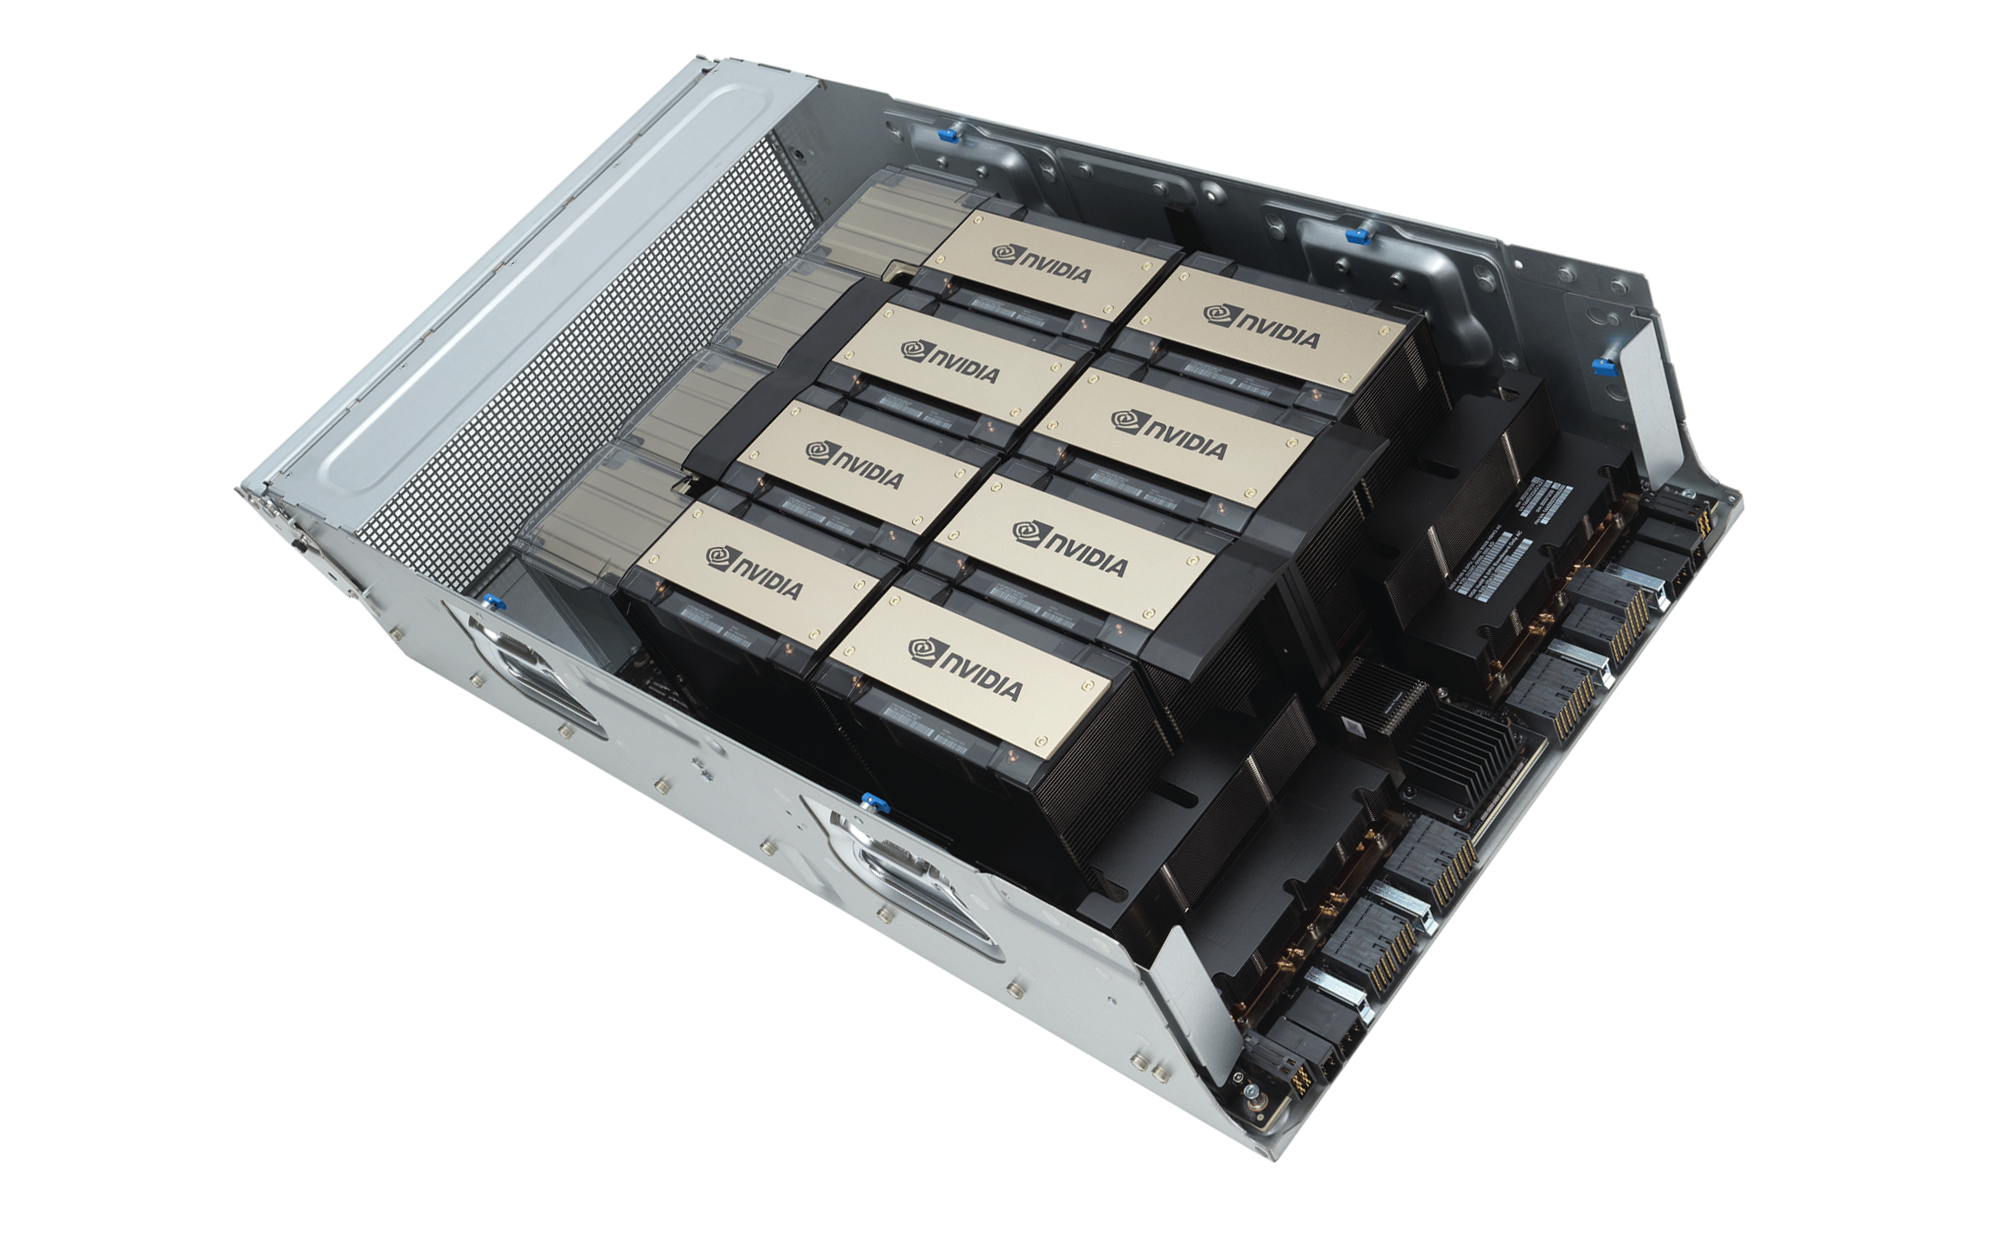
NVIDIA HGX H200 是基于 Hopper 架构的 8 卡 GPU 整机模组,板载 8 颗 H200 141GB SXM5 GPU,为首款 HBM3e 显存 GPU 模组,合计约 1.1TB 显存,单卡带宽 4.8TB/s,8 卡聚合 38TB/s。8 卡经第四代 NVLink 全互联,每卡 900GB/s,FP8 单卡 3,958 TFLOPS,面向超大模型训练推理。
Product Highlights
HBM3e: Massive Memory and Bandwidth
单颗 H200 配备 141GB HBM3e 显存,容量较 H100 接近翻倍,单卡显存带宽 4.8TB/s,8 卡合计约 1.1TB 显存、38TB/s 聚合带宽,从容容纳超大模型。
Fourth-Generation NVLink and FP8 Compute
8 卡通过 NVSwitch 全互联,每卡 NVLink 带宽 900GB/s;Hopper Transformer Engine 支持 FP8,单卡 FP8 3,958 TFLOPS、BF16/FP16 1,979 TFLOPS,合计约 32 PFLOPS。
Network and DPU Acceleration
集成 BlueField-3 DPU 与 Quantum-2 InfiniBand/Spectrum-X 以太网(最高 400Gb/s),支持 MIG 多实例、机密计算,面向超大规模生成式 AI 云。
Product Specifications
| GPU Model | NVIDIA H200 141GB SXM5(Hopper 架构) |
| Number of GPUs | 8 颗 |
| VRAM capacity | 1,128GB HBM3e(141GB×8,约 1.1TB) |
| Memory bandwidth | 4.8TB/s(单卡),8 卡聚合 38TB/s |
| NVLink Interconnect | 900GB/s,第四代 NVSwitch 全互联 |
| PCIe | PCIe Gen5,128GB/s |
| FP32 | 67 TFLOPS(单卡) |
| TF32 Tensor Core | 989 TFLOPS(单卡) |
| BF16/FP16 Tensor Core | 1,979 TFLOPS(单卡) |
| FP8 Tensor Core | 3,958 TFLOPS(单卡),合计约 32 PFLOPS |
| Single-card TDP | 最高约 700W(SXM5) |
| MIG Multi-Instance | 最多 7 个实例 |
| Network/DPU | BlueField-3 DPU,400Gb/s InfiniBand/以太网 |
Use Cases
- 超大模型训练与推理
- 生成式 AI 云服务
- 长上下文 LLM 部署
- 超大规模智算集群